يونيو 2026
هل تستطيع النماذج اللغوية الكبيرة ترميز البيانات الإنسانية النوعية بموثوقية؟ دراسة مرجعية مقارنةً بتحكيم الخبراء البشريين
تُرجمت هذه الصفحة آليًا وقد تحتوي على أخطاء. اقرأ النسخة الإنجليزية
بقلم Jerome Marston، Tino Kreutzer، Salomé Garnier، Ella Boone، Phuong N. Pham، Patrick Vinck
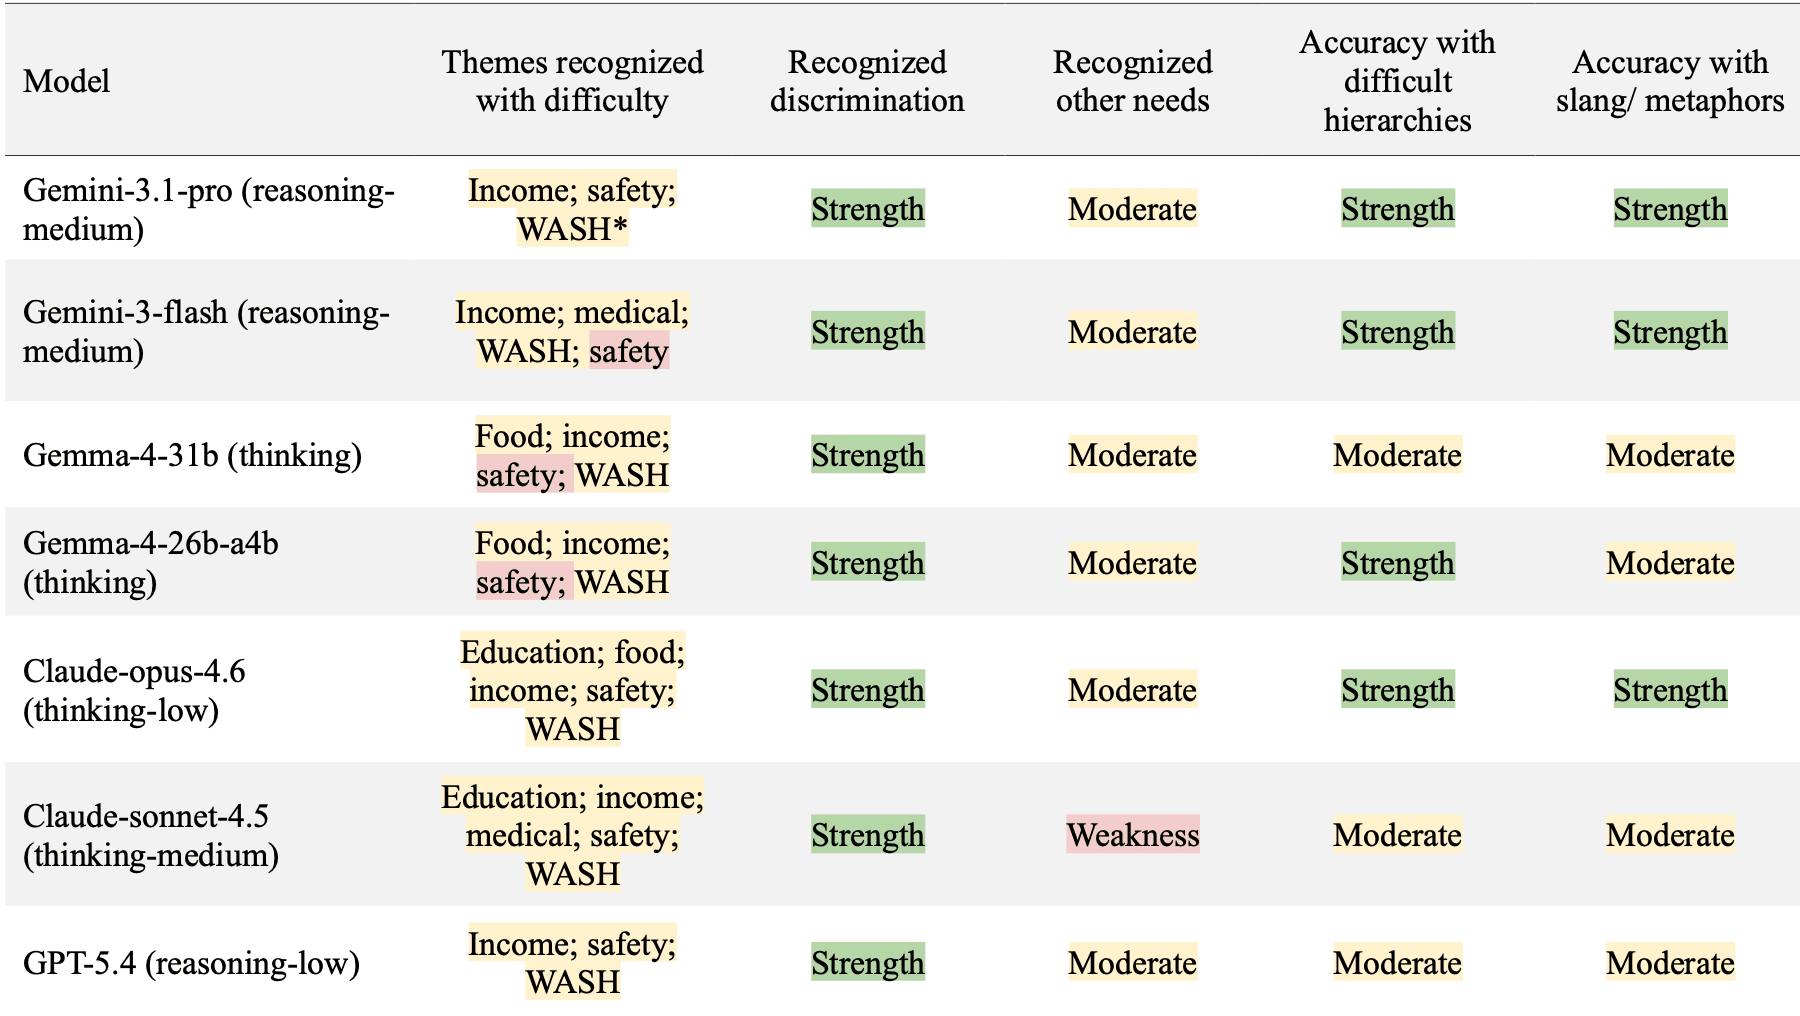
دراسة تقيّم موثوقية 46 نموذجًا لغويًا كبيرًا (LLMs) في ترميز البيانات الإنسانية النوعية. وقد أظهرت النماذج الأعلى أداءً من Anthropic وGoogle وOpenAI دقة تراوحت بين 90 و93%، وهو ما يضاهي متوسط أداء المرمّزين البشريين. وفي حين تفوّقت هذه النماذج في تحديد الاحتياجات الإنسانية مثل الغذاء والرعاية الطبية، كانت أقل دقة في رصد المخاوف المتعلقة بالحماية، مثل السلامة الجسدية والتمييز، أو الاحتياجات المعبَّر عنها بلغة غير مباشرة كالعامية أو المجاز. وتشير نتائج الدراسة إلى أن النماذج اللغوية الكبيرة يمكن أن توفّر وقتًا كبيرًا وتعزّز قدرة المنظمات الإنسانية على ترميز البيانات النوعية، لكنها لا تُغني عن الحكم البشري. ويختتم المقال بمناقشة أفضل الممارسات، بما في ذلك الإشراف البشري متعدد المستويات ونشر النماذج مفتوحة الأوزان على بنية تحتية مستضافة ذاتيًا للتعامل مع البيانات الإنسانية الحساسة. والمنهجية المعروضة قابلة للتكرار، ويمكن استخدامها لاختبار النماذج اللغوية الكبيرة الجديدة فور إتاحتها.