jun 2026
¿Pueden los modelos de lenguaje de gran tamaño codificar de forma fiable datos humanitarios cualitativos? Un estudio comparativo frente a la adjudicación de personas expertas
Esta página se tradujo automáticamente y puede contener errores. Leer la versión en inglés
Por Jerome Marston, Tino Kreutzer, Salomé Garnier, Ella Boone, Phuong N. Pham, Patrick Vinck
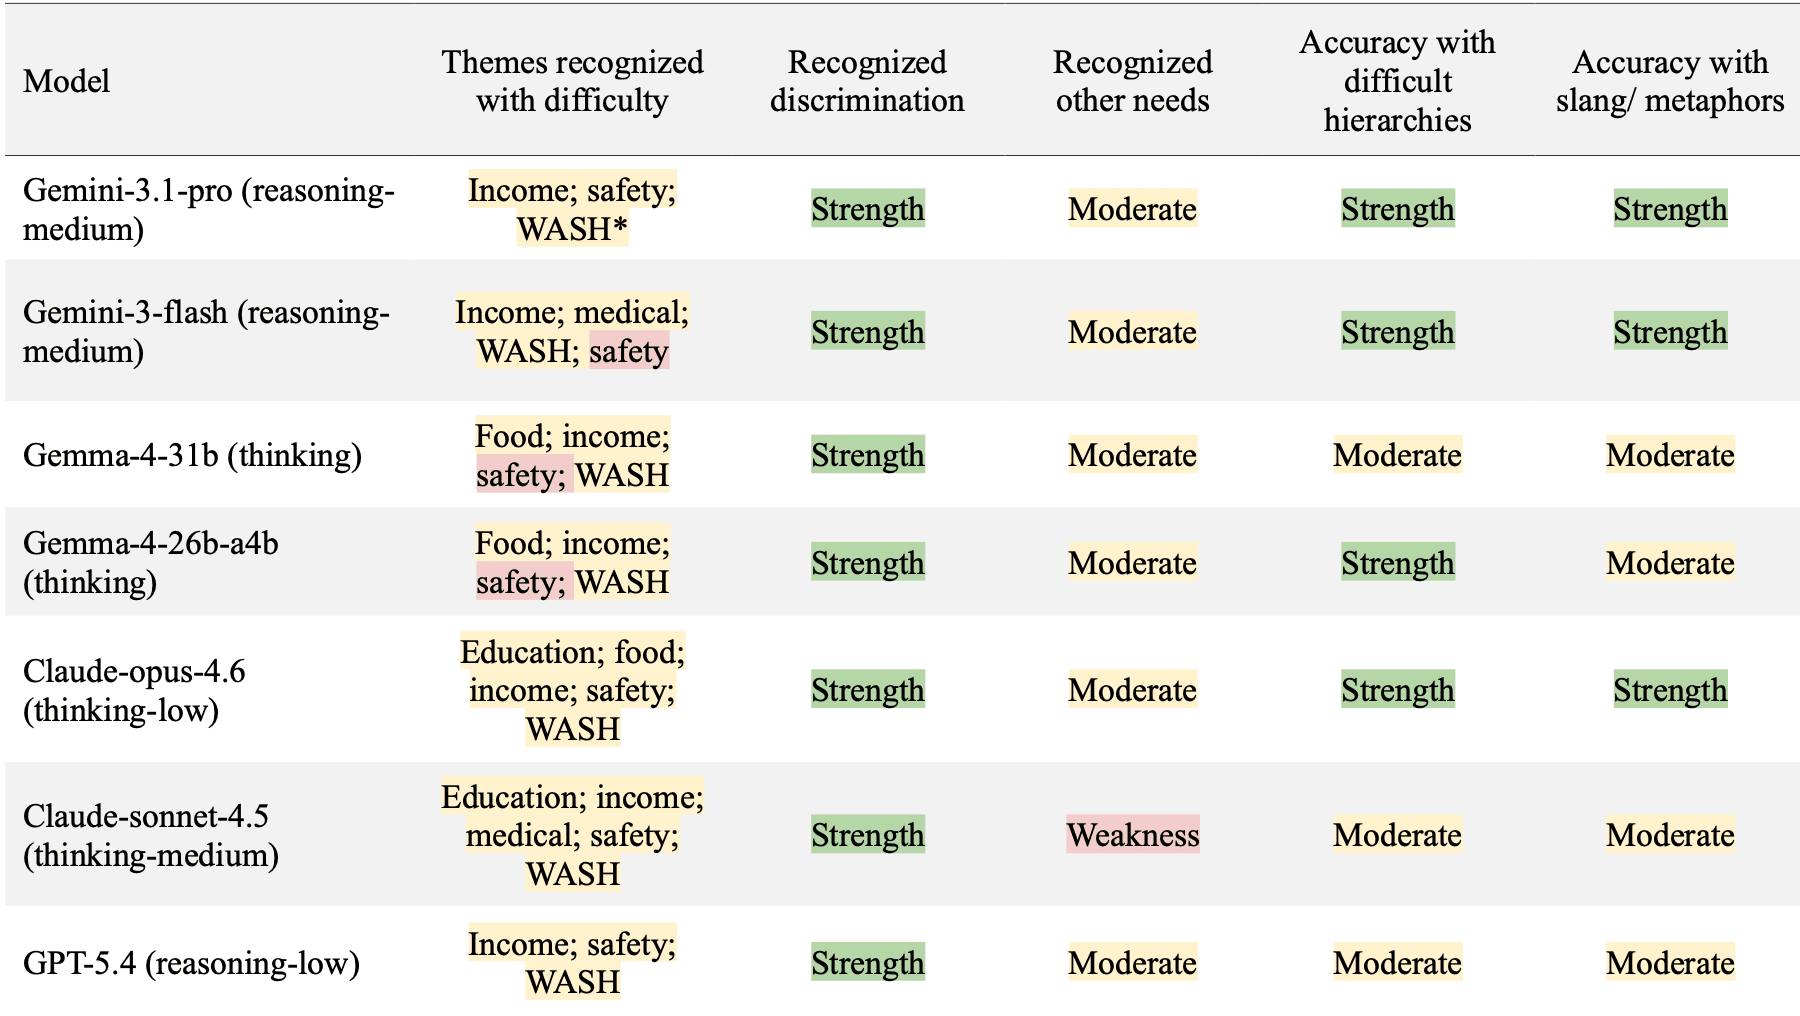
Estudio que evalúa la fiabilidad de 46 modelos de lenguaje de gran tamaño (LLM) para codificar datos humanitarios cualitativos. Los modelos con mejor desempeño de Anthropic, Google y OpenAI alcanzaron una precisión del 90-93%, equivalente a la de un codificador humano promedio. Aunque los mejores modelos sobresalieron en la identificación de necesidades humanitarias como alimentos y atención médica, fueron menos precisos al detectar preocupaciones de protección, como la seguridad física y la discriminación, o necesidades expresadas en lenguaje indirecto, como jerga o metáforas. Los hallazgos del estudio indican que los LLM pueden ahorrar mucho tiempo y ampliar la capacidad de las organizaciones humanitarias para codificar datos cualitativos, pero que no sustituyen el criterio humano. El artículo concluye con un análisis de buenas prácticas, entre ellas la supervisión humana escalonada y el despliegue de modelos de pesos abiertos en infraestructura propia para los datos humanitarios sensibles. La metodología presentada es reproducible y puede utilizarse para evaluar nuevos LLM a medida que estén disponibles.