juin 2026
Les grands modèles de langage peuvent-ils coder de manière fiable des données humanitaires qualitatives ? Étude comparative face à l'arbitrage d'experts humains
Cette page a été traduite automatiquement et peut contenir des erreurs. Lire la version anglaise
Par Jerome Marston, Tino Kreutzer, Salomé Garnier, Ella Boone, Phuong N. Pham, Patrick Vinck
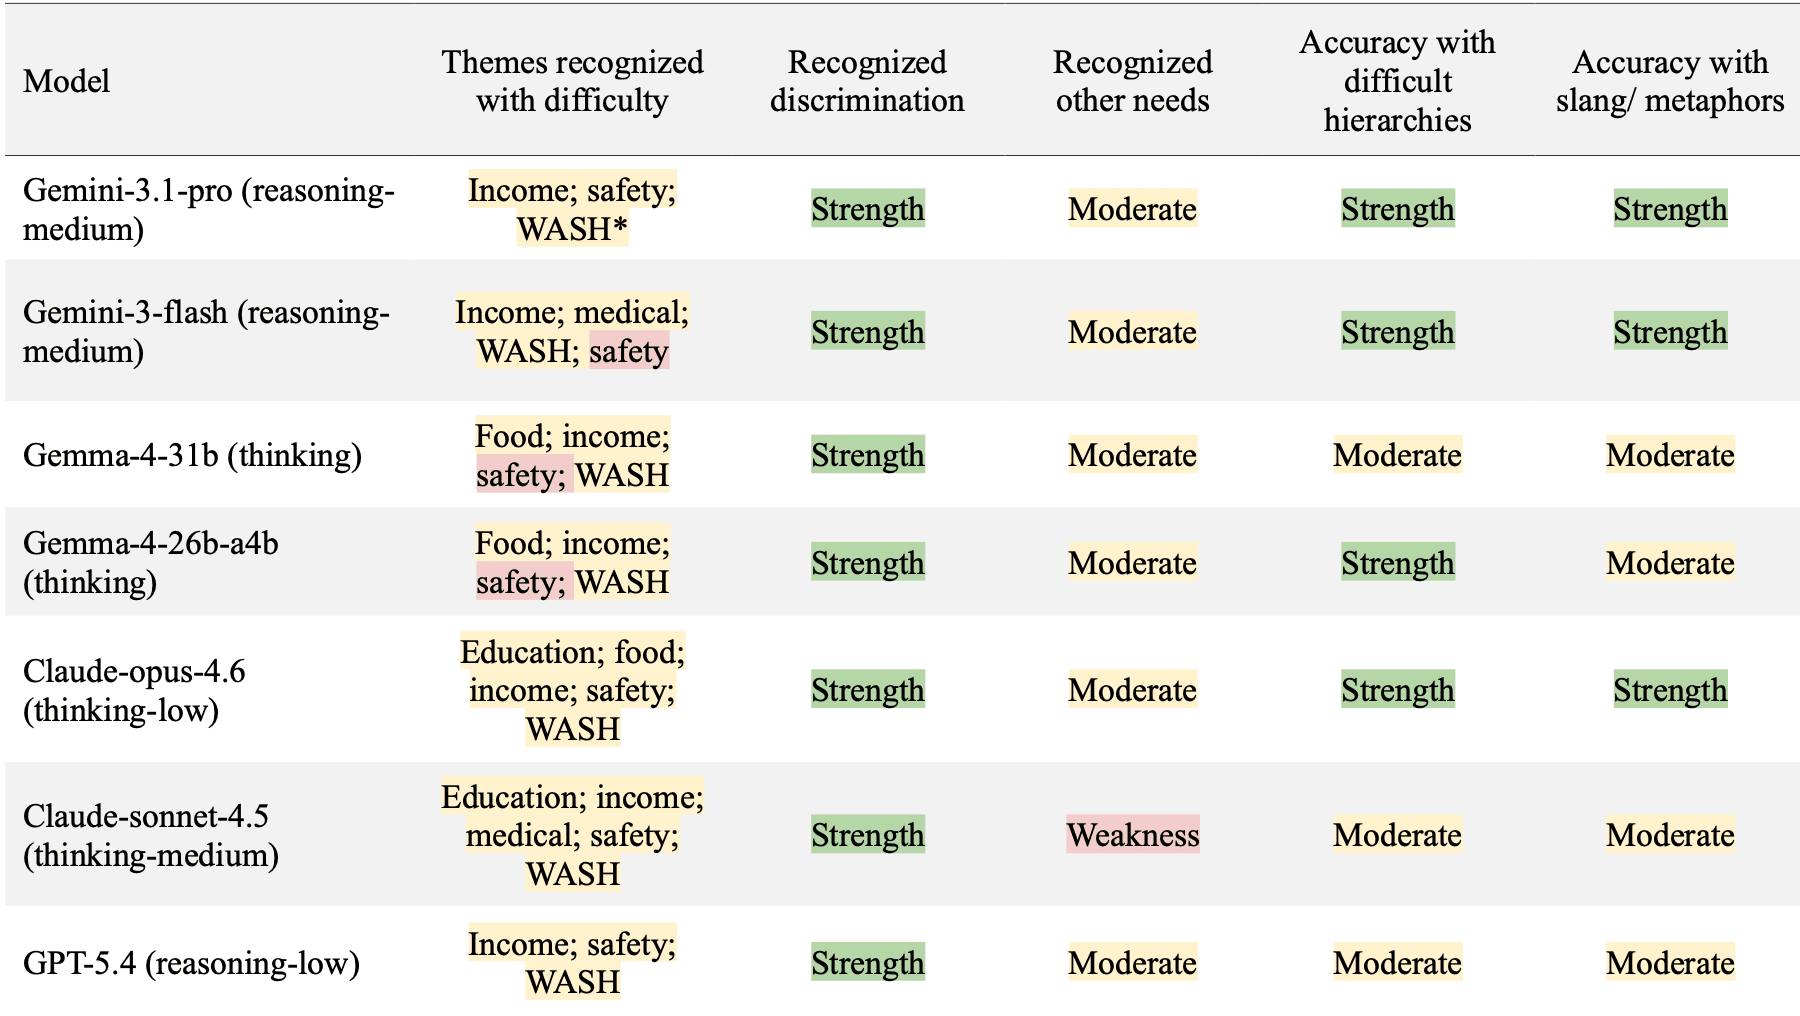
Étude évaluant la fiabilité de 46 grands modèles de langage (LLM) pour le codage de données humanitaires qualitatives. Les modèles les plus performants d'Anthropic, de Google et d'OpenAI ont atteint une précision de 90 à 93 %, au niveau des codeurs humains moyens. S'ils excellent à repérer des besoins humanitaires comme l'alimentation et les soins médicaux, ils sont moins précis pour détecter les préoccupations liées à la protection, telles que la sécurité physique et la discrimination, ou les besoins exprimés de manière indirecte, par exemple en argot ou par métaphore. Selon les résultats de l'étude, les LLM peuvent faire gagner un temps considérable et renforcer la capacité des organisations humanitaires à coder des données qualitatives, mais ils ne remplacent pas le jugement humain. L'article se termine par une discussion des bonnes pratiques, notamment une supervision humaine à plusieurs niveaux et le déploiement de modèles à poids ouverts sur une infrastructure auto-hébergée pour les données humanitaires sensibles. La méthodologie présentée est reproductible et peut servir à tester les nouveaux LLM à mesure qu'ils apparaissent.